Las traducciones son generadas a través de traducción automática. En caso de conflicto entre la traducción y la version original de inglés, prevalecerá la version en inglés.
Configurar y personalizar las consultas para las bases de conocimiento administradas
Puede configurar y personalizar la recuperación para mejorar aún más la relevancia de los resultados. Por ejemplo, puede aplicar filtros a los metadatos de los documentos fields/attributes para usar los documentos actualizados más recientemente o los documentos con tiempos de modificación recientes.
nota
Todas las configuraciones siguientes solo se aplican a fuentes de datos no estructuradas.
Para obtener más información sobre estas configuraciones en la consola o la API, seleccione uno de los siguientes temas:
Cuando consulta una base de conocimientos, Amazon Bedrock devuelve hasta cinco resultados en la respuesta de forma predeterminada. Cada resultado corresponde a un fragmento de origen.
nota
El número real de resultados de la respuesta puede ser inferior al valor de numberOfResults especificado, ya que este parámetro establece el número máximo de resultados que se devuelven. Si ha configurado la fragmentación jerárquica para su estrategia de fragmentación, el parámetro numberOfResults se asigna al número de fragmentos secundarios que recuperará la base de conocimiento. Como los fragmentos secundarios que comparten el mismo fragmento principal se sustituyen por el fragmento principal en la respuesta final, es posible que la cantidad de resultados devueltos sea inferior a la cantidad solicitada.
Para modificar el número máximo de resultados que se devuelven, seleccione la pestaña correspondiente al método que prefiera y siga estos pasos:
Puede aplicar filtros al documento fields/attributes para mejorar aún más la relevancia de las respuestas. Sus fuentes de datos pueden incluir metadatos de documentos attributes/fields para filtrarlos y pueden especificar qué campos incluir en las incrustaciones.
Consideraciones sobre la base de conocimientos gestionada
Al utilizar el filtrado de metadatos con una base de conocimientos gestionada:
-
Los filtros
startsWithy destringContainsmetadatos no son compatibles. En su lugarequalsgreaterThanlessThan, utilicenotInlos operadoresin,,, u. -
Los operadores de rango (
greaterThan,greaterThanOrEqualslessThan, ylessThanOrEquals) aceptan un valor numérico o de fecha y hora. Para filtrar por fecha y hora, proporcione el valor en forma de cadena en ISO-8601 formato de fecha y hora desfasado. Utilice el formulario de desfase completo, por ejemplo,.2026-03-02T19:02:18ZLos operadores de rango admiten valores de cadenas de fecha y hora solo para las bases de conocimiento administradas. -
En el caso de las bases de conocimiento personalizadas, el servicio reserva los campos de metadatos con
x-amz-bedrockel prefijo. En el caso de las bases de conocimiento totalmente administradas, los campos de metadatos reservados utilizan un prefijo de subrayado (por ejemplo,,_source_uri)._data_source_idNo puede anular los campos de metadatos reservados en ninguno de los tipos de base de conocimientos.
Por ejemplo, “epoch_modification_time” representa el tiempo en segundos transcurridos desde el 1 de enero de 1970 (UTC) hasta que se actualizó el documento por última vez. Puede filtrar por los datos más recientes, donde “epoch_modification_time” es mayor que un número determinado. Estos documentos más recientes se pueden utilizar para la consulta.
Para utilizar filtros al consultar una base de conocimientos, compruebe que la base de conocimientos cumpla los siguientes requisitos:
-
Al configurar el conector del origen de datos, la mayoría de los conectores rastrea los principales campos de metadatos de los documentos. Si utiliza un bucket de Amazon S3 como origen de datos, el bucket debe incluir al menos un
fileName.extension.metadata.jsonpara el archivo o documento con el que está asociado. Consulte Campos de metadatos del documento Configuración de la conexión para obtener más información sobre cómo configurar el archivo de metadatos. -
Si el índice vectorial de su base de conocimientos se encuentra en un almacén vectorial de Amazon OpenSearch Serverless, compruebe que el índice vectorial esté configurado con el
faissmotor. Si el índice vectorial está configurado con el motornmslib, deberá realizar una de las siguientes acciones:-
Cree una nueva base de conocimientos en la consola y deje que Amazon Bedrock cree automáticamente un índice vectorial en Amazon OpenSearch Serverless para usted.
-
Crear otro índice vectorial en el almacén vectorial y seleccionar
faisscomo el motor. A continuación, cree una nueva base de conocimientos y especifique el nuevo índice vectorial.
-
-
Si su base de conocimiento utiliza un índice vectorial en un bucket vectorial de S3, no puede utilizar los filtros
startsWithystringContains. -
Si va a añadir metadatos a un índice vectorial existente en un clúster de base de datos de Amazon Aurora, le recomendamos que proporcione el nombre de campo de la columna de metadatos personalizada para almacenar todos los metadatos en una sola columna. Durante la ingesta de datos, esta columna se utilizará para rellenar toda la información de los archivos de metadatos de los orígenes de datos. Si decide proporcionar este campo, debe crear un índice en esta columna.
-
Cuando cree una nueva base de conocimiento en la consola y deje que Amazon Bedrock configure su base de datos de Amazon Aurora, creará automáticamente una sola columna para usted y la rellenará con la información de sus archivos de metadatos.
-
Si decide crear otro índice vectorial en el almacén de vectores, debe proporcionar el nombre del campo de metadatos personalizado para almacenar la información de sus archivos de metadatos. Si no proporciona este nombre de campo, debe crear una columna para cada atributo de metadatos de sus archivos y especificar el tipo de datos (texto, número o booleano). Por ejemplo, si existiera el atributo
genreen el origen de datos, añadiría una columna con el nombregenrey especificaríatextcomo tipo de datos. Durante la ingesta de datos, estas columnas se rellenarán con los valores de atributo correspondientes.
-
Si tiene documentos PDF en su fuente de datos y utiliza Amazon OpenSearch Serverless o Amazon Aurora para su almacén vectorial, las bases de conocimiento de Amazon Bedrock generarán los números de página de los documentos y los almacenarán en un metadato denominado x-amz-bedrock-kb-document-page-number. field/attribute Tenga en cuenta que los números de página almacenados en un campo de metadatos no se admiten si elige no fragmentar sus documentos.
Puede utilizar los siguientes operadores de filtrado para filtrar los resultados al realizar consultas:
| Operador | Consola | Nombre del filtro de la API | Tipos de datos de atributos compatibles | Resultados filtrados |
|---|---|---|---|---|
| Igual a | = | equals | cadena, número, booleano | El atributo coincide con el valor que ha proporcionado |
| No es igual a | != | notEquals | cadena, número, booleano | El atributo no coincide con el valor que ha proporcionado |
| Mayor que | > | greaterThan | número | El atributo es mayor que el valor que ha proporcionado |
| Mayor que o igual a | >= | mayor ThanOrEquals | número | El atributo es mayor que o igual al valor que ha proporcionado |
| Menor que | < | lessThan | número | El atributo es menor que el valor que ha proporcionado |
| Menor que o igual a | <= | menos ThanOrEquals | número | El atributo es menor que o igual al valor que ha proporcionado |
| In | : | in | lista de cadenas | El atributo está en la lista que usted proporciona (actualmente es mejor compatible con los almacenes vectoriales GraphRag de Amazon OpenSearch Serverless y Neptune Analytics) |
| No en | !: | notIn | lista de cadenas | El atributo no está en la lista que nos proporciona (actualmente es más compatible con los almacenes vectoriales GraphRag de Amazon OpenSearch Serverless y Neptune Analytics) |
| Contiene una cadena | No disponible | stringContains | cadena | El atributo debe ser una cadena. El nombre del atributo coincide con la clave y su valor es una cadena que contiene el valor que ha proporcionado como subcadena, o una lista con un miembro que contiene el valor que ha proporcionado como subcadena (actualmente es más compatible con el almacén vectorial Amazon Serverless). OpenSearch El almacén vectorial GraphRag de Neptune Analytics admite la variante de cadena (pero no la variante de lista de este filtro). |
| Contiene una lista | No disponible | listContains | cadena | El atributo debe ser una lista de cadenas. El nombre del atributo coincide con la clave y su valor es una lista que contiene el valor que usted proporcionó como uno de sus miembros (actualmente es más compatible con las tiendas vectoriales de Amazon OpenSearch Serverless). |
Para combinar los operadores de filtrado, puede usar los siguientes operadores lógicos:
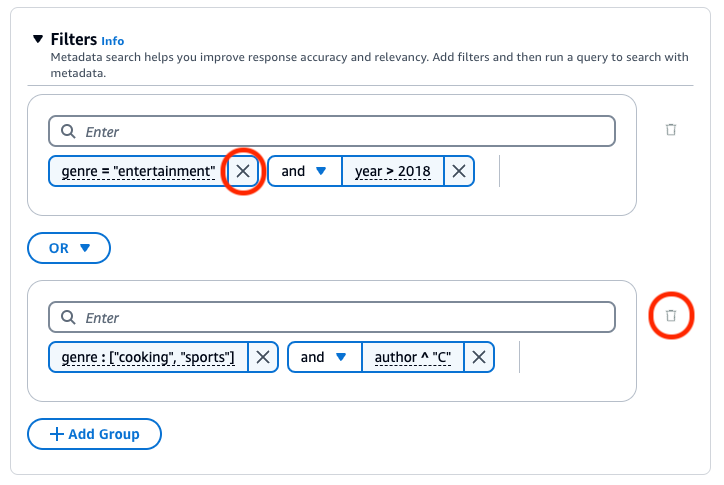
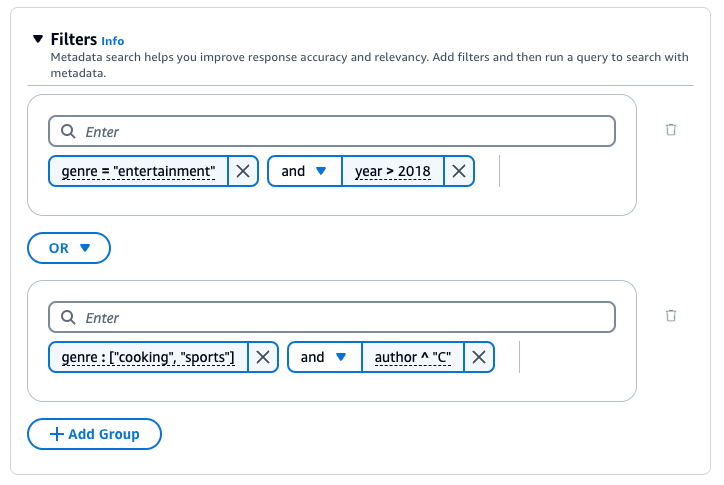
Para obtener información sobre cómo filtrar los resultados con los metadatos, seleccione la pestaña correspondiente al método que prefiera y siga estos pasos:
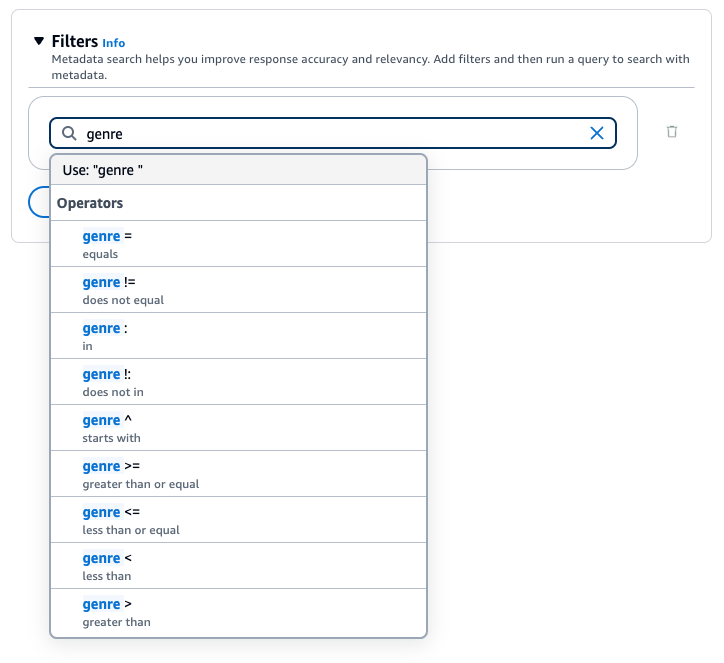

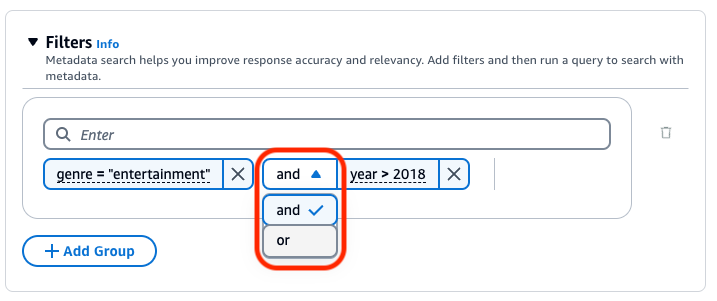
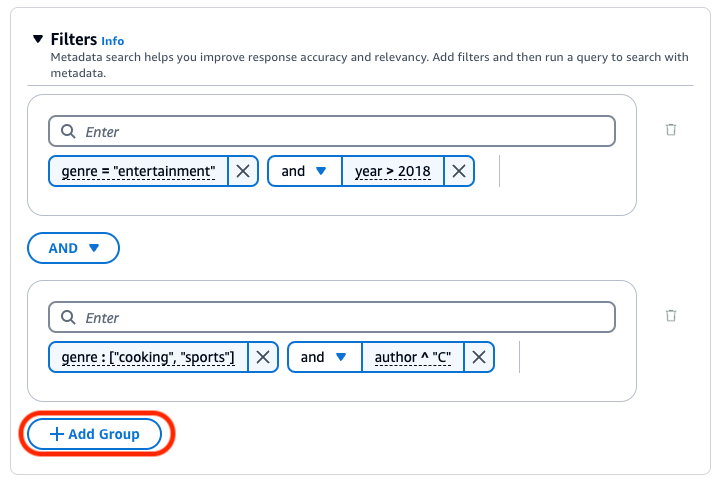
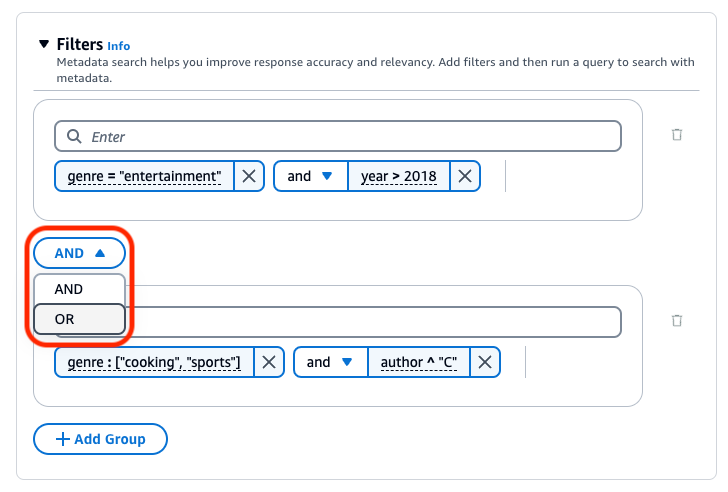
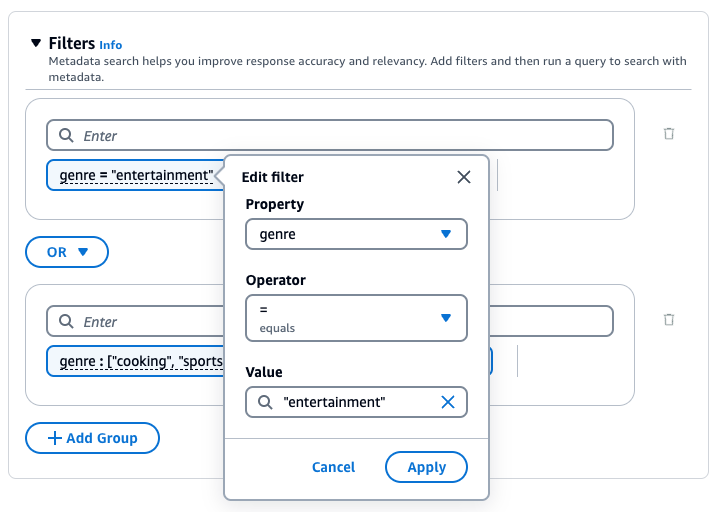
 ) situado junto al grupo. Para eliminar un filtro, seleccione el icono de eliminación (
 ) junto al filtro.
Puede implementar protecciones en la base de conocimientos para sus casos de uso y políticas de IA responsable. Puede crear varias barreras de protección adaptadas a diferentes casos de uso y aplicarlas en diferentes condiciones de solicitud y respuesta para proporcionar una experiencia de usuario coherente y estandarizar los controles de seguridad en toda la base de conocimientos. Puede configurar los temas denegados para que no se admitan temas no deseados y filtros de contenido para bloquear el contenido dañino en las entradas y respuestas del modelo. Para obtener más información, consulte Detección y filtrado del contenido dañino mediante Barreras de protección para Amazon Bedrock.
nota
Actualmente, Claude 3 Sonnet y Haiku no admiten el uso de barreras de protección con fundamento contextual para las bases de conocimientos.
Para ver las directrices generales de ingeniería de peticiones, consulte Conceptos de ingeniería de peticiones.
Elija la pestaña del método que prefiera y siga estos pasos:
Puede utilizar un modelo reclasificador para recuperar los resultados de una consulta a la base de conocimiento. Siga los pasos de la consola que se indican en Consulta de una base de conocimiento y recuperación de datos. Cuando abra el panel Configuraciones, amplíe la sección Reordenamiento. Seleccione un modelo reclasificador, actualice los permisos si es necesario y modifique las opciones adicionales. Introduzca una petición y seleccione Ejecutar para probar los resultados después de la reclasificación.
