Les traductions sont fournies par des outils de traduction automatique. En cas de conflit entre le contenu d'une traduction et celui de la version originale en anglais, la version anglaise prévaudra.
Utilisation d'EMR Serverless avec AWS Lake Formation pour un contrôle d'accès précis
Vue d’ensemble
Avec les versions 7.2.0 et supérieures d'Amazon EMR, tirez parti AWS Lake Formation de l'application de contrôles d'accès précis aux tables du catalogue de données soutenues par S3. Cette fonctionnalité vous permet de configurer les contrôles d'accès au niveau des tables, des lignes, des colonnes et des cellules pour les read requêtes dans le cadre de vos jobs Amazon EMR Serverless Spark. Pour configurer un contrôle d'accès précis pour les tâches par lots et les sessions interactives d'Apache Spark, utilisez EMR Studio. Consultez les sections suivantes pour en savoir plus sur Lake Formation et comment l'utiliser avec EMR Serverless.
L'utilisation d'Amazon EMR Serverless AWS Lake Formation entraîne des frais supplémentaires. Pour plus d'informations, consultez la rubrique Tarification d'
Comment fonctionne EMR Serverless avec AWS Lake Formation
L'utilisation d'EMR Serverless avec Lake Formation vous permet d'appliquer une couche d'autorisations à chaque tâche Spark afin d'appliquer le contrôle des autorisations Lake Formation lorsque EMR Serverless exécute des tâches. EMR Serverless utilise les profils de ressources Spark
Lorsque vous utilisez une capacité pré-initialisée avec Lake Formation, nous vous suggérons de disposer d'au moins deux pilotes Spark. Chaque Formation-enabled tâche Lake utilise deux pilotes Spark, l'un pour le profil utilisateur et l'autre pour le profil système. Pour des performances optimales, utilisez deux fois plus de pilotes pour Lake Formation-enabled jobs que si vous n'utilisez pas Lake Formation.
Lorsque vous exécutez des tâches Spark sur EMR Serverless, tenez également compte de l'impact de l'allocation dynamique sur la gestion des ressources et les performances du cluster. La configuration spark.dynamicAllocation.maxExecutors du nombre maximum d'exécuteurs par profil de ressource s'applique aux exécuteurs utilisateur et système. Si vous configurez ce nombre pour qu'il soit égal au nombre maximum autorisé d'exécuteurs, l'exécution de votre tâche peut être bloquée à cause d'un type d'exécuteur qui utilise toutes les ressources disponibles, ce qui empêche l'autre exécuteur lorsque vous exécutez des tâches.
Pour ne pas manquer de ressources, EMR Serverless définit le nombre maximum d'exécuteurs par défaut par profil de ressource à 90 % de la valeur. spark.dynamicAllocation.maxExecutors Vous pouvez modifier cette configuration lorsque vous spécifiez spark.dynamicAllocation.maxExecutorsRatio une valeur comprise entre 0 et 1. Configurez également les propriétés suivantes pour optimiser l'allocation des ressources et les performances globales :
-
spark.dynamicAllocation.cachedExecutorIdleTimeout -
spark.dynamicAllocation.shuffleTracking.timeout -
spark.cleaner.periodicGC.interval
Vous trouverez ci-dessous un aperçu de haut niveau de la manière dont EMR Serverless accède aux données protégées par les politiques de sécurité de Lake Formation.
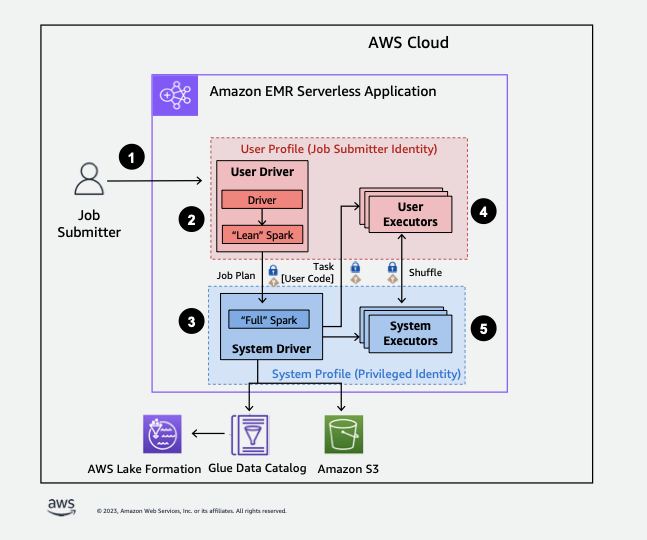
-
Un utilisateur soumet une tâche Spark à une application EMR Serverless AWS Lake Formation activée.
-
EMR Serverless envoie la tâche à un pilote utilisateur et l'exécute dans le profil utilisateur. Le pilote utilisateur exécute une version allégée de Spark qui n’est pas en mesure de lancer des tâches, de demander des exécuteurs, d’accéder à S3 ni au catalogue Glue. Il crée un plan de tâche.
-
EMR Serverless configure un second pilote appelé pilote système et l'exécute dans le profil système (avec une identité privilégiée). EMR Serverless met en place un canal TLS chiffré entre les deux pilotes pour la communication. Le pilote utilisateur utilise le canal pour envoyer les plans de tâche au pilote système. Le pilote système n’exécute pas le code soumis par l’utilisateur. Il exécute Spark dans son intégralité et communique avec S3 et le catalogue de données pour l’accès aux données. Il demande des exécuteurs et compile le plan de tâche en une séquence d’étapes d’exécution.
-
EMR Serverless exécute ensuite les étapes sur les exécuteurs avec le pilote utilisateur ou le pilote système. À n’importe quelle étape, le code utilisateur est exécuté exclusivement sur les exécuteurs de profil utilisateur.
-
Les étapes qui lisent les données des tables du catalogue de données protégées par des filtres de sécurité AWS Lake Formation ou celles qui appliquent des filtres de sécurité sont déléguées aux exécuteurs du système.
Favoriser la formation de lacs dans Amazon EMR
Pour activer Lake Formation, définissez sur spark.emr-serverless.lakeformation.enabled true spark-defaults Sous-classification pour le paramètre de configuration d'exécution lors de la création d'une application EMR Serverless.
aws emr-serverless create-application \
    --release-label emr-7.14.0 \
    --runtime-configuration '{
     "classification": "spark-defaults",
     "properties": {
      "spark.emr-serverless.lakeformation.enabled": "true"
      }
    }' \
    --type "SPARK"
Vous pouvez également activer Lake Formation lorsque vous créez une nouvelle application dans EMR Studio. Choisissez Utiliser Lake Formation pour un contrôle d'accès précis, disponible sous Configurations supplémentaires.
Inter-worker le chiffrement est activé par défaut lorsque vous utilisez Lake Formation avec EMR Serverless, il n'est donc pas nécessaire de réactiver explicitement le chiffrement inter-travailleurs.
Favoriser la formation de lacs pour les emplois de Spark
Pour activer Lake Formation pour des tâches Spark individuelles, réglez sur spark.emr-serverless.lakeformation.enabled true lors de l'utilisationspark-submit.
--conf spark.emr-serverless.lakeformation.enabled=true
Autorisations IAM du rôle d’exécution des tâches
Les autorisations de Lake Formation contrôlent l'accès aux ressources du catalogue de données AWS Glue, aux emplacements Amazon S3 et aux données sous-jacentes de ces emplacements. Les autorisations IAM contrôlent l'accès aux API et aux ressources de Lake Formation et AWS Glue. Bien que vous ayez l’autorisation Lake Formation d’accéder à une table du catalogue de données (SELECT), votre opération échoue si vous ne disposez pas de l’autorisation IAM sur l’opération d’API glue:Get*.
Voici un exemple de politique expliquant comment fournir les autorisations IAM pour accéder à un script dans Amazon S3, le chargement de journaux sur S3, les autorisations d’API AWS Glue et les autorisations d’accès à Lake Formation.
Configuration des autorisations de Lake Formation pour le rôle d’exécution des tâches
Tout d’abord, enregistrez l’emplacement de votre table Hive avec Lake Formation. Créez ensuite des autorisations pour votre rôle d’exécution des tâches dans la table de votre choix. Pour plus de détails sur la formation des lacs, reportez-vous à la section Qu'est-ce que c'est AWS Lake Formation ? dans le Guide AWS Lake Formation du développeur.
Après avoir configuré les autorisations de Lake Formation, soumettez des tâches Spark sur Amazon EMR Serverless. Pour plus d'informations sur les jobs Spark, consultez les exemples Spark.
Soumission d’une exécution de tâche
Une fois que vous avez terminé de configurer les subventions Lake Formation, vous pouvez soumettre des tâches Spark sur EMR Serverless. La section suivante présente des exemples de configuration et de soumission des propriétés d'exécution des tâches.
Conditions d'autorisation
Tables non enregistrées dans AWS Lake Formation
Pour les tables non enregistrées auprès de AWS Lake Formation, le rôle d'exécution de la tâche accède à la fois au catalogue de données AWS Glue et aux données de table sous-jacentes dans Amazon S3. Cela nécessite que le rôle d'exécution de la tâche dispose des autorisations IAM appropriées pour les opérations AWS Glue et Amazon S3.
Tables enregistrées dans AWS Lake Formation
Pour les tables enregistrées auprès de AWS Lake Formation, le rôle d'exécution des tâches accède aux métadonnées du catalogue de données AWS Glue, tandis que les informations d'identification temporaires fournies par Lake Formation accèdent aux données de table sous-jacentes dans Amazon S3. Les autorisations Lake Formation requises pour exécuter une opération dépendent du catalogue de données AWS Glue et des appels d'API Amazon S3 lancés par la tâche Spark et peuvent être résumées comme suit :
-
L'autorisation DESCRIBE permet au rôle d'exécution de lire les métadonnées d'une table ou d'une base de données dans le catalogue de données
-
L'autorisation ALTER permet au rôle d'exécution de modifier les métadonnées des tables ou des bases de données dans le catalogue de données
-
L'autorisation DROP permet au rôle d'exécution de supprimer les métadonnées de table ou de base de données du catalogue de données
-
L'autorisation SELECT permet au rôle d'exécution de lire les données des tables depuis Amazon S3
-
L'autorisation INSERT permet au rôle d'exécution d'écrire des données de table dans Amazon S3
-
L'autorisation DELETE permet au rôle d'exécution de supprimer les données des tables d'Amazon S3
Note
Lake Formation évalue les autorisations de manière paresseuse lorsqu'une tâche Spark appelle AWS Glue pour récupérer les métadonnées des tables et Amazon S3 pour récupérer les données des tables. Les tâches qui utilisent un rôle d'exécution avec des autorisations insuffisantes n'échoueront pas tant que Spark n'aura pas effectué un appel AWS Glue ou Amazon S3 nécessitant l'autorisation manquante.
Note
Dans la matrice de tableaux prise en charge suivante :
-
Les opérations marquées comme prises en charge utilisent exclusivement les informations d'identification de Lake Formation pour accéder aux données des tables enregistrées auprès de Lake Formation. Si les autorisations de Lake Formation sont insuffisantes, l'opération ne reviendra pas aux informations d'identification du rôle d'exécution. Pour les tables non enregistrées auprès de Lake Formation, les informations d'identification du rôle d'exécution de la tâche accèdent aux données de la table.
-
Les opérations marquées comme prises en charge avec des autorisations IAM sur un emplacement Amazon S3 n'utilisent pas les informations d'identification Lake Formation pour accéder aux données de table sous-jacentes dans Amazon S3. Pour exécuter ces opérations, le rôle d'exécution de la tâche doit disposer des autorisations IAM Amazon S3 nécessaires pour accéder aux données de la table, que celle-ci soit enregistrée auprès de Lake Formation ou non.
Note
À partir d'Amazon EMR 7.12, les opérations DML et DDL qui modifient les données des tables utilisent les informations d'identification Lake Formation. Dans Amazon EMR 7.11 et les versions antérieures, ces opérations (à l'exception de DELETE, UPDATE et MERGE) utilisent les informations d'identification du rôle d'exécution de la tâche pour modifier les données de la table. Amazon EMR 7.11 et les versions antérieures ne prennent pas en charge les opérations DELETE, UPDATE et MERGE.
