Les traductions sont fournies par des outils de traduction automatique. En cas de conflit entre le contenu d'une traduction et celui de la version originale en anglais, la version anglaise prévaudra.
Utiliser des étapes prédéfinies
Lorsque vous créez un flux de travail, vous pouvez choisir d'ajouter l'une des étapes prédéfinies suivantes décrites dans cette rubrique. Vous pouvez également choisir d'ajouter vos propres étapes de traitement de fichiers personnalisées. Pour de plus amples informations, veuillez consulter Utiliser des étapes de traitement de fichiers personnalisées.
Rubriques
Copier le fichier
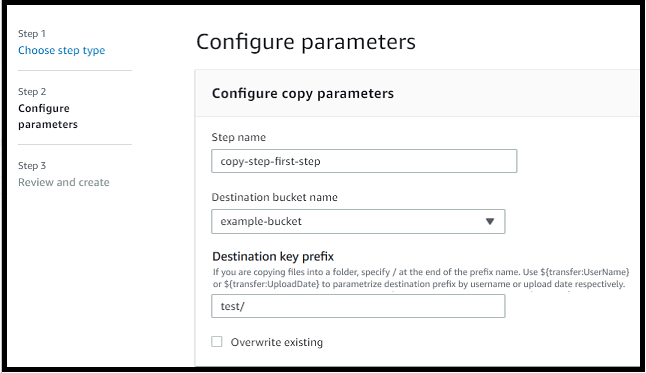
Une étape de copie du fichier crée une copie du fichier chargé dans un nouvel emplacement Amazon S3. Actuellement, vous pouvez utiliser une étape de copie de fichier uniquement avec Amazon S3.
L'étape de copie de fichier suivante copie les fichiers dans le test dossier situé dansamzn-s3-demo-destination-bucket.
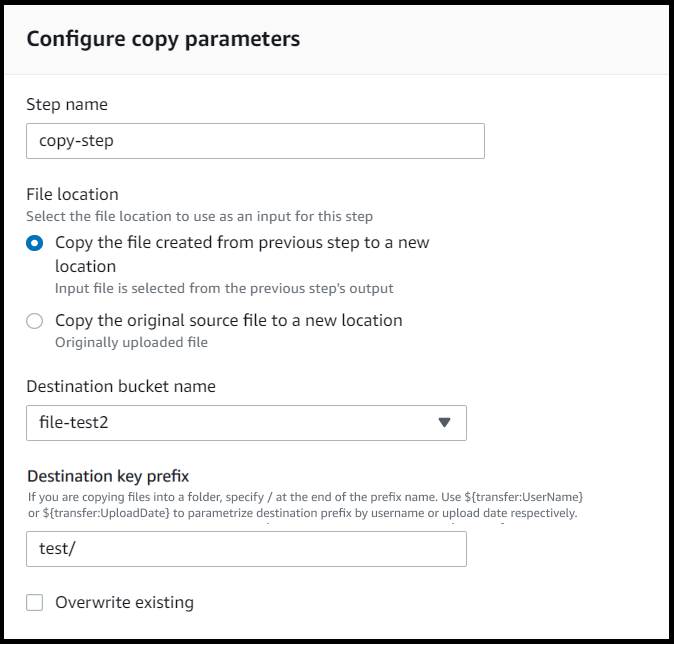
Si l'étape de copie du fichier n'est pas la première étape de votre flux de travail, vous pouvez spécifier l'emplacement du fichier. En spécifiant l'emplacement du fichier, vous pouvez copier soit le fichier utilisé à l'étape précédente, soit le fichier d'origine chargé. Vous pouvez utiliser cette fonctionnalité pour créer plusieurs copies du fichier d'origine tout en conservant le fichier source intact pour l'archivage des fichiers et la conservation des enregistrements. Pour obtenir un exemple, consultez Exemple de flux de travail de balisage et de suppression.
Fournissez le compartiment et les détails clés
Vous devez fournir le nom du compartiment et une clé pour la destination de l'étape de copie du fichier. La clé peut être un nom de chemin ou un nom de fichier. Le fait que la clé soit traitée comme un nom de chemin ou comme un nom de fichier dépend du fait que vous terminiez la clé par une barre oblique (/).
Si le dernier caractère est/, votre fichier est copié dans le dossier et son nom ne change pas. Si le caractère final est alphanumérique, votre fichier téléchargé est renommé avec la valeur clé. Dans ce cas, si un fichier portant ce nom existe déjà, le comportement dépend du paramètre du champ Remplacer l'existant.
-
Si l'option Remplacer l'existant est sélectionnée, le fichier existant est remplacé par le fichier en cours de traitement.
-
Si l'option Remplacer l'existant n'est pas sélectionnée, rien ne se passe et le traitement du flux de travail s'arrête.
Astuce
Si des écritures simultanées sont exécutées sur le même chemin de fichier, cela peut entraîner un comportement inattendu lors du remplacement de fichiers.
Par exemple, si votre valeur de clé esttest/, les fichiers que vous avez chargés sont copiés test dans le dossier. Si votre valeur de clé esttest/today, (et que l'option Remplacer les fichiers existants est sélectionnée), chaque fichier que vous chargez est copié today dans un fichier nommé dans le test dossier, et chaque fichier suivant remplace le précédent.
Note
Amazon S3 prend en charge les compartiments et les objets. Il n’y a aucune hiérarchie. Cependant, vous pouvez utiliser des préfixes et des délimiteurs dans les noms de clés d'objets pour impliquer une hiérarchie et organiser vos données de la même manière que les dossiers.
Utiliser une variable nommée dans une étape de copie de fichier
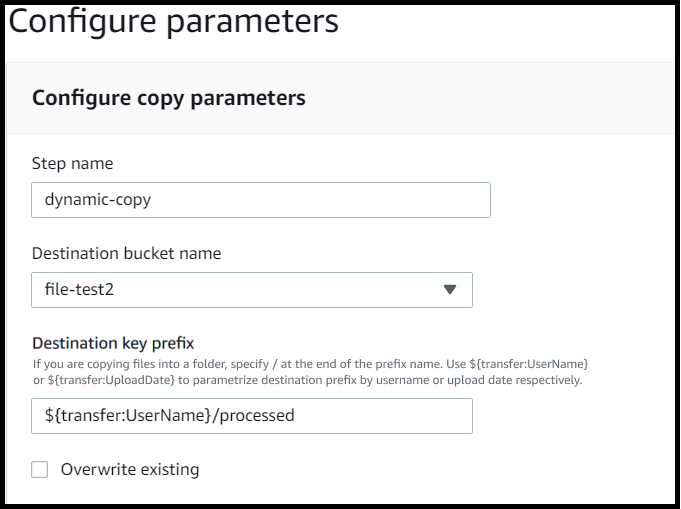
Lors d'une étape de copie de fichier, vous pouvez utiliser une variable pour copier dynamiquement vos fichiers dans des dossiers spécifiques à l'utilisateur. Actuellement, vous pouvez utiliser ${transfer:UserName} ou ${transfer:UploadDate} en tant que variable pour copier des fichiers vers un emplacement de destination pour l'utilisateur qui télécharge les fichiers, ou en fonction de la date actuelle.
Dans l'exemple suivant, si l'utilisateur richard-roe télécharge un fichier, celui-ci est copié dans le amzn-s3-demo-destination-bucket/richard-roe/processed/ dossier. Si l'utilisateur mary-major télécharge un fichier, celui-ci est copié dans le amzn-s3-demo-destination-bucket/mary-major/processed/ dossier.
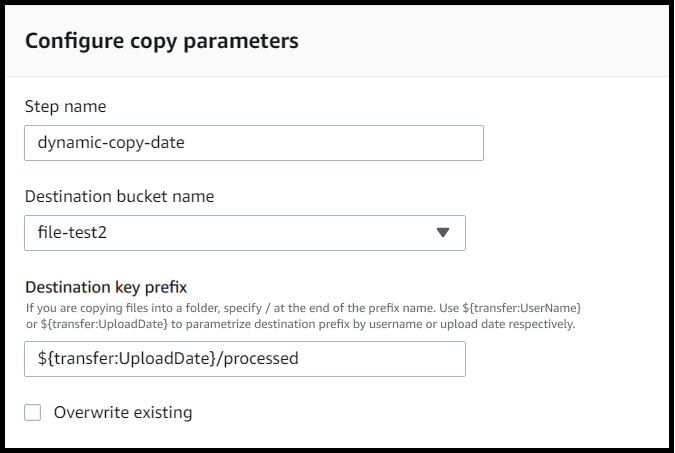
De même, vous pouvez l'utiliser ${transfer:UploadDate} comme variable pour copier des fichiers vers un emplacement de destination nommé d'après la date du jour. Dans l'exemple suivant, si vous définissez la destination ${transfer:UploadDate}/processed sur le 1er février 2022, les fichiers chargés sont copiés dans le amzn-s3-demo-destination-bucket/2022-02-01/processed/ dossier.
Vous pouvez également utiliser ces deux variables ensemble, en combinant leurs fonctionnalités. Par exemple, vous pouvez définir le préfixe de la clé de destination surfolder/${transfer:UserName}/${transfer:UploadDate}/, ce qui créerait des dossiers imbriqués, par exemple. folder/marymajor/2023-01-05/
Autorisations IAM pour l'étape de copie
Pour permettre à une étape de copie de réussir, assurez-vous que le rôle d'exécution de votre flux de travail contient les autorisations suivantes.
{
    "Sid": "ListBucket",
    "Effect": "Allow",
    "Action": "s3:ListBucket",
    "Resource": [
        "arn:aws:s3:::amzn-s3-demo-destination-bucket"
    ]
}, {
    "Sid": "HomeDirObjectAccess",
    "Effect": "Allow",
    "Action": [
        "s3:PutObject",
        "s3:GetObject",
        "s3:DeleteObjectVersion",
        "s3:DeleteObject",
        "s3:GetObjectVersion"
    ],
    "Resource": "arn:aws:s3:::amzn-s3-demo-destination-bucket/*"
}
Note
L's3:ListBucketautorisation n'est nécessaire que si vous ne sélectionnez pas Remplacer l'existant. Cette autorisation vérifie votre compartiment pour voir si un fichier portant le même nom existe déjà. Si vous avez sélectionné Remplacer l'existant, le flux de travail n'a pas besoin de rechercher le fichier et peut simplement l'écrire.
Si vos fichiers Amazon S3 comportent des balises, vous devez ajouter une ou deux autorisations à votre politique IAM.
-
Ajoutez
s3:GetObjectTaggingun fichier Amazon S3 qui n'est pas versionné. -
Ajoutez
s3:GetObjectVersionTaggingpour obtenir un fichier Amazon S3 versionné.
Décrypter le fichier
Le blog sur le AWS stockage contient un article qui décrit comment déchiffrer simplement des fichiers sans écrire de code à l'aide des flux de travail gérés par Transfer Family, chiffrer et déchiffrer des fichiers avec PGP et. AWS Transfer Family
Algorithmes de chiffrement symétriques pris en charge
Pour le déchiffrement PGP, Transfer Family prend en charge les algorithmes de chiffrement symétriques utilisés pour chiffrer les données réelles des fichiers PGP.
-
Pour des informations détaillées sur les algorithmes de chiffrement symétriques pris en charge, consultezAlgorithmes de chiffrement symétriques PGP.
-
Pour plus d'informations sur les algorithmes de paires de clés PGP utilisés avec ces algorithmes symétriques, consultez. Algorithmes de paires de clés PGP
Utilisez le déchiffrement PGP dans votre flux de travail
Transfer Family dispose d'un support intégré pour le décryptage Pretty Good Privacy (PGP). Vous pouvez utiliser le déchiffrement PGP sur les fichiers chargés via SFTP, FTPS ou FTP vers Amazon Simple Storage Service (Amazon S3) ou Amazon Elastic File System (Amazon EFS).
Pour utiliser le déchiffrement PGP, vous devez créer et stocker les clés privées PGP qui seront utilisées pour le déchiffrement de vos fichiers. Vos utilisateurs peuvent ensuite chiffrer les fichiers à l'aide des clés de chiffrement PGP correspondantes avant de les télécharger sur votre serveur Transfer Family. Après avoir reçu les fichiers chiffrés, vous pouvez les déchiffrer dans votre flux de travail. Pour voir un didacticiel détaillé, consultez Configuration d'un flux de travail géré pour le déchiffrement d'un fichier.
Pour plus d'informations sur les algorithmes PGP pris en charge et les recommandations, consultezAlgorithmes de chiffrement et de déchiffrement PGP.
Pour utiliser le déchiffrement PGP dans votre flux de travail
-
Identifiez un serveur Transfer Family pour héberger votre flux de travail ou créez-en un nouveau. Vous devez disposer de l'ID du serveur pour pouvoir stocker vos clés PGP AWS Secrets Manager avec le nom secret correct.
-
Enregistrez votre clé PGP AWS Secrets Manager sous le nom secret requis. Pour en savoir plus, consultez Gérer les clés PGP. Les flux de travail peuvent localiser automatiquement la clé PGP correcte à utiliser pour le déchiffrement en fonction du nom secret dans Secrets Manager.
Note
Lorsque vous stockez des secrets dans Secrets Manager, des frais Compte AWS vous sont facturés. Pour plus d’informations sur la tarification, consultez la section AWS Secrets Manager Tarification
. -
Chiffrez un fichier à l'aide de votre paire de clés PGP. (Pour obtenir la liste des clients pris en charge, consultezClients PGP pris en charge.) Si vous utilisez la ligne de commande, exécutez la commande suivante. Pour utiliser cette commande, remplacez-la
username@example.comtestfile.txtgpg -e -rusername@example.comtestfile.txtImportant
Lorsque vous chiffrez des fichiers destinés à être utilisés avec des AWS Transfer Family flux de travail, assurez-vous toujours de spécifier un destinataire non anonyme à l'aide du
-rparamètre. Le chiffrement anonyme (sans spécifier de destinataire) peut provoquer des échecs de déchiffrement dans le flux de travail car le système ne sera pas en mesure d'identifier la clé à utiliser pour le déchiffrement. Les informations de débogage relatives à ce problème sont disponibles à l'adresseRésoudre les problèmes de chiffrement des destinataires anonymes. -
Téléchargez le fichier crypté sur votre serveur Transfer Family.
-
Configurez une étape de déchiffrement dans votre flux de travail. Pour de plus amples informations, veuillez consulter Ajouter une étape de déchiffrement.
Ajouter une étape de déchiffrement
Une étape de déchiffrement déchiffre un fichier chiffré qui a été chargé sur Amazon S3 ou Amazon EFS dans le cadre de votre flux de travail. Pour plus de détails sur la configuration du déchiffrement, consultezUtilisez le déchiffrement PGP dans votre flux de travail.
Lorsque vous créez l'étape de déchiffrement d'un flux de travail, vous devez spécifier la destination des fichiers déchiffrés. Vous devez également choisir de remplacer les fichiers existants si un fichier existe déjà à l'emplacement de destination. Vous pouvez surveiller les résultats du flux de déchiffrement et obtenir des journaux d'audit pour chaque fichier en temps réel à l'aide d'Amazon CloudWatch Logs.
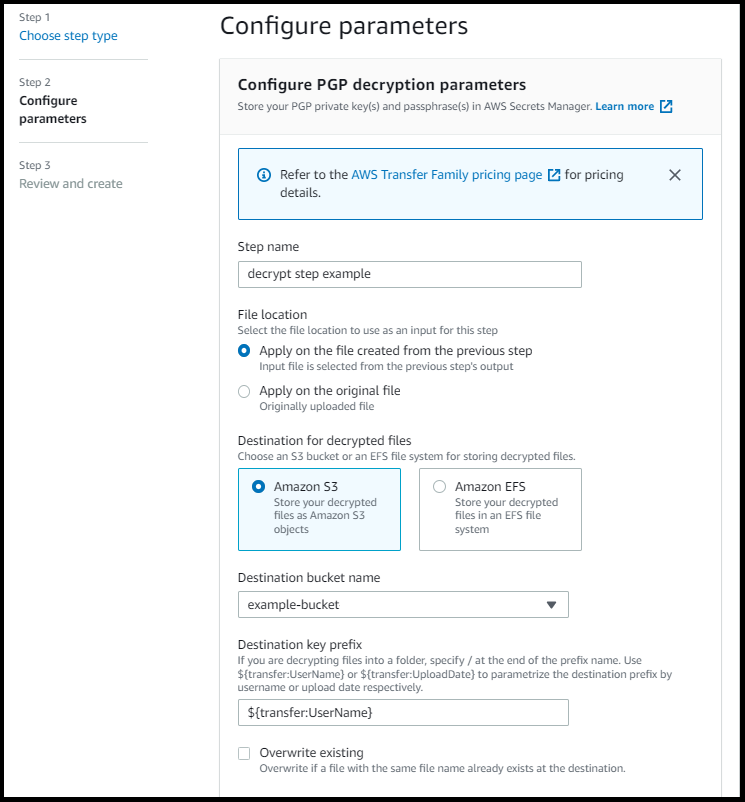
Une fois que vous avez choisi le type de fichier de déchiffrement pour votre étape, la page Configurer les paramètres apparaît. Renseignez les valeurs de la section Configurer les paramètres de déchiffrement PGP.
Les options disponibles sont les suivantes :
-
Nom de l'étape — Entrez un nom descriptif pour l'étape.
-
Emplacement du fichier : en spécifiant l'emplacement du fichier, vous pouvez déchiffrer soit le fichier utilisé à l'étape précédente, soit le fichier d'origine chargé.
Note
Ce paramètre n'est pas disponible s'il s'agit de la première étape du flux de travail.
-
Destination des fichiers déchiffrés : choisissez un compartiment Amazon S3 ou un système de fichiers Amazon EFS comme destination du fichier déchiffré.
-
Si vous choisissez Amazon S3, vous devez fournir un nom de compartiment de destination et un préfixe de clé de destination. Pour paramétrer le préfixe de la clé de destination par nom d'utilisateur, entrez le champ Préfixe de la clé
${transfer:UserName}de destination. De même, pour paramétrer le préfixe de clé de destination par date de téléchargement, entrez dans Préfixe de clé${Transfer:UploadDate}de destination. -
Si vous choisissez Amazon EFS, vous devez fournir un système de fichiers et un chemin de destination.
Note
L'option de stockage que vous choisissez ici doit correspondre au système de stockage utilisé par le serveur Transfer Family auquel ce flux de travail est associé. Dans le cas contraire, vous recevrez un message d'erreur lorsque vous tenterez d'exécuter ce flux de travail.
-
-
Remplacer l'existant : si vous chargez un fichier et qu'un fichier portant le même nom existe déjà sur le site de destination, le comportement dépend de la définition de ce paramètre :
-
Si l'option Remplacer l'existant est sélectionnée, le fichier existant est remplacé par le fichier en cours de traitement.
-
Si l'option Remplacer l'existant n'est pas sélectionnée, rien ne se passe et le traitement du flux de travail s'arrête.
Astuce
Si des écritures simultanées sont exécutées sur le même chemin de fichier, cela peut entraîner un comportement inattendu lors du remplacement de fichiers.
-
La capture d'écran suivante montre un exemple des options que vous pourriez choisir pour l'étape de déchiffrement de votre fichier.
Autorisations IAM pour l'étape de déchiffrement
Pour permettre à une étape de déchiffrement de réussir, assurez-vous que le rôle d'exécution de votre flux de travail contient les autorisations suivantes.
{
    "Sid": "ListBucket",
    "Effect": "Allow",
    "Action": "s3:ListBucket",
    "Resource": [
        "arn:aws:s3:::amzn-s3-demo-destination-bucket"
    ]
}, {
    "Sid": "HomeDirObjectAccess",
    "Effect": "Allow",
    "Action": [
        "s3:PutObject",
        "s3:GetObject",
        "s3:DeleteObjectVersion",
        "s3:DeleteObject",
        "s3:GetObjectVersion"
    ],
    "Resource": "arn:aws:s3:::amzn-s3-demo-destination-bucket/*"
}, {
    "Sid": "Decrypt",
    "Effect": "Allow",
    "Action": [
        "secretsmanager:GetSecretValue",
    ],
    "Resource": "arn:aws:secretsmanager:region:account-id:secret:aws/transfer/*"
}
Note
L's3:ListBucketautorisation n'est nécessaire que si vous ne sélectionnez pas Remplacer l'existant. Cette autorisation vérifie votre compartiment pour voir si un fichier portant le même nom existe déjà. Si vous avez sélectionné Remplacer l'existant, le flux de travail n'a pas besoin de rechercher le fichier et peut simplement l'écrire.
Si vos fichiers Amazon S3 comportent des balises, vous devez ajouter une ou deux autorisations à votre politique IAM.
-
Ajoutez
s3:GetObjectTaggingun fichier Amazon S3 qui n'est pas versionné. -
Ajoutez
s3:GetObjectVersionTaggingpour obtenir un fichier Amazon S3 versionné.
Fichier de balises
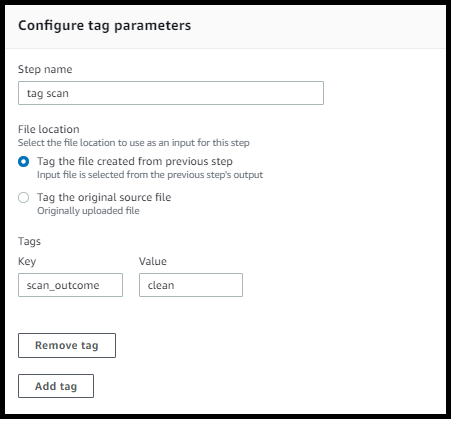
Pour baliser les fichiers entrants en vue d'un traitement ultérieur en aval, utilisez une étape de marquage. Entrez la valeur de la balise que vous souhaitez attribuer aux fichiers entrants. Actuellement, l'opération de marquage n'est prise en charge que si vous utilisez Amazon S3 pour le stockage de votre serveur Transfer Family.
L'exemple d'étape de balise suivant assigne scan_outcome et clean en tant que clé et valeur de balise, respectivement.
Pour permettre à une étape de balise de réussir, assurez-vous que le rôle d'exécution de votre flux de travail contient les autorisations suivantes.
{
            "Sid": "Tag",
            "Effect": "Allow",
            "Action": [
                "s3:PutObjectTagging",
                "s3:PutObjectVersionTagging"
            ],
            "Resource": [
                "arn:aws:s3:::amzn-s3-demo-bucket/*"
            ]
}
Note
Si votre flux de travail contient une étape de balise qui s'exécute avant une étape de copie ou de déchiffrement, vous devez ajouter une ou deux autorisations à votre politique IAM.
-
Ajoutez
s3:GetObjectTaggingun fichier Amazon S3 qui n'est pas versionné. -
Ajoutez
s3:GetObjectVersionTaggingpour obtenir un fichier Amazon S3 versionné.
Supprimer le fichier
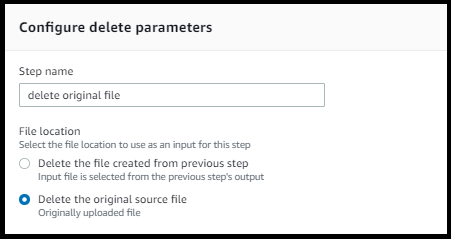
Pour supprimer un fichier traité lors d'une étape précédente du flux de travail ou pour supprimer le fichier initialement chargé, utilisez une étape de suppression du fichier.
Pour permettre à une étape de suppression de réussir, assurez-vous que le rôle d'exécution de votre flux de travail contient les autorisations suivantes.
{
            "Sid": "Delete",
            "Effect": "Allow",
            "Action": [
                "s3:DeleteObjectVersion",
                "s3:DeleteObject"
            ],
            "Resource": "arn:aws:secretsmanager:region:account-ID:secret:aws/transfer/*"
        }
Variables nommées pour les flux de travail
Pour les étapes de copie et de déchiffrement, vous pouvez utiliser une variable pour effectuer des actions de manière dynamique. Prend actuellement en AWS Transfer Family charge les variables nommées suivantes.
-
Permet
${transfer:UserName}de copier ou de déchiffrer des fichiers vers une destination en fonction de l'utilisateur qui les télécharge. -
Permet
${transfer:UploadDate}de copier ou de déchiffrer des fichiers vers un emplacement de destination en fonction de la date actuelle.
Exemple de flux de travail de balisage et de suppression
L'exemple suivant illustre un flux de travail qui étiquette les fichiers entrants qui doivent être traités par une application en aval, telle qu'une plateforme d'analyse de données. Après avoir balisé le fichier entrant, le flux de travail supprime le fichier initialement chargé afin de réduire les coûts de stockage.